
متا روز دوشنبه از دو مدل هوش مصنوعی جدید خود با نامهای «Muse Wonder» و «Muse Wonder Full» رونمایی کرد. این دو مدل از پیشرفتهترین مدلهای این شرکت به شمار میروند و نخستین تلاش متا برای عرضه مدلی در سطح پیشرفتهترین فناوریهای هوش مصنوعی محسوب میشوند.
پیش از این، متا مدل Muse Spark را معرفی کرده بود که هدف اصلی آن ارائه پاسخهای سریع و انجام وظایف با کمترین تأخیر ممکن بود. اما مدلهای جدید Wonder و Wonder Full در مقایسه با Muse Spark بزرگتر هستند و تواناییهای بیشتری دارند. به گفته متا، این دو مدل در آزمونهای مختلف امتیازهای بالاتری کسب کردهاند و در انجام کارهای پیچیده، از جمله برنامهنویسی و نوشتن کد، عملکرد بهتری از خود نشان میدهند.
بر اساس نتایج آزمایشهای متا که در مستندات فنی این مدلها منتشر شده است، عملکرد Muse Wonder و Muse Wonder Full در برخی آزمونهای استاندارد با مدلهای Fable 5.1 و GPT-6 Astra قابل مقایسه است. این نتایج نشان میدهد که متا قصد دارد جایگاه خود را در رقابت با شرکتهای پیشرو در زمینه توسعه هوش مصنوعی تقویت کند.
در مطلبی که در وبلاگ رسمی متا منتشر شده، این شرکت مدلهای جدید را گام بعدی در مسیر توسعه و افزایش تواناییهای هوش مصنوعی خود معرفی کرده است. متا همچنین تأکید کرده که این مدلها میتوانند شرکت را به هدف ساخت هوش مصنوعی شخصی و بسیار پیشرفته، یا همان «ابرهوش شخصی»، نزدیکتر کنند. چنین سامانهای قرار است با شناخت بهتر کاربران، نیازها و ترجیحات آنها، کمکهای دقیقتر و کاربردیتری ارائه دهد.
تواناییهای بیشتر این مدلها در قیمتگذاری آنها نیز دیده میشود. کاربرانی که از طریق رابط برنامهنویسی کاربردی (API) متا به مدل Wonder دسترسی پیدا میکنند، باید برای هر یک میلیون توکن ورودی 4 دلار و برای هر یک میلیون توکن خروجی 20 دلار پرداخت کنند. توکنها بخشهای کوچکی از متن هستند که مدل هوش مصنوعی هنگام دریافت اطلاعات و تولید پاسخ آنها را پردازش میکند. با این قیمتها، هزینه استفاده از Wonder تقریباً با هزینه مدلهای GPT-6 Sol و Opus 5.5 برابر است.
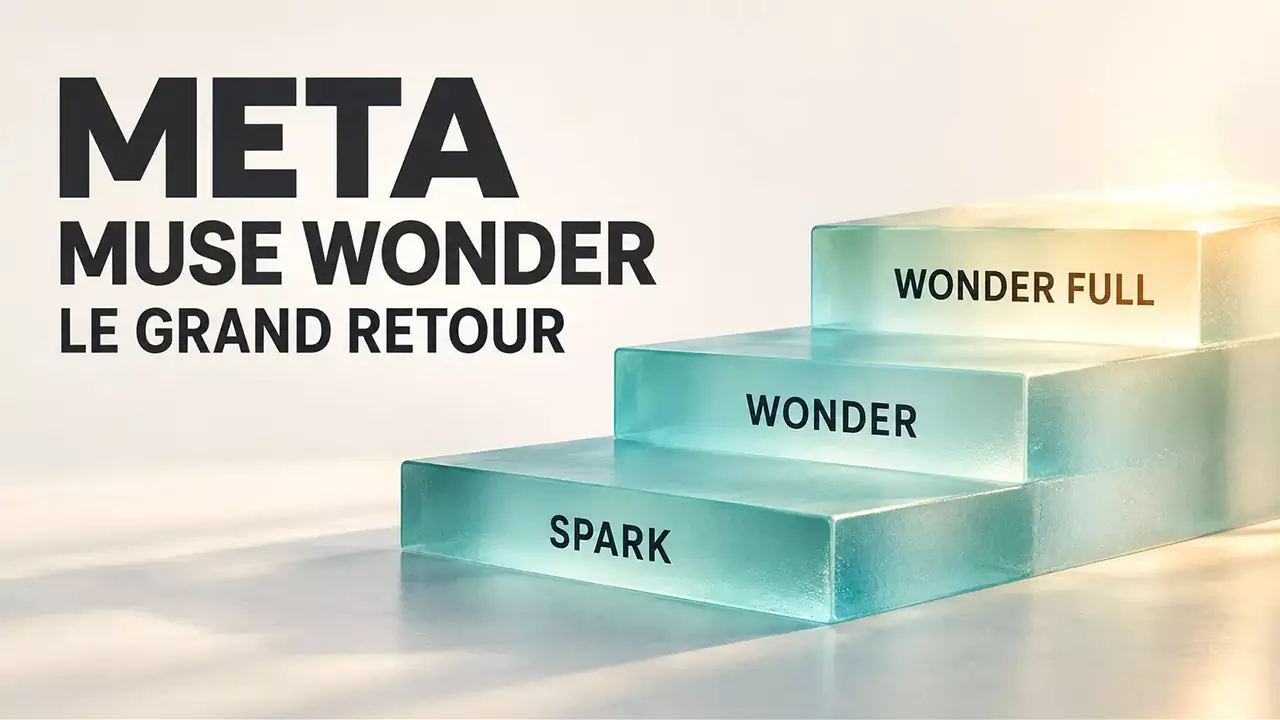
با این حال، مدل Wonder Full محدودیت بیشتری در دسترسی دارد. این مدل فقط برای مشترکان سرویس Muse Code ارائه میشود و از طریق API در دسترس نخواهد بود. متا اعلام کرده است که هر دو مدل جدید برای تقویت و بهبود عملکرد دستیار هوش مصنوعی Muse نیز به کار گرفته خواهند شد.
یکی از مهمترین ویژگیهایی که متا در معرفی این مدلها بر آن تأکید کرده، توانایی حفظ و ترکیب اطلاعات مربوط به کاربران است. این شرکت این قابلیت را «حافظه فعال» یا Active Memory مینامد. هدف از این ویژگی آن است که دستیار هوش مصنوعی بتواند اطلاعات مهمی را که کاربر در طول زمان در اختیارش قرار میدهد، به خاطر بسپارد و در گفتگوها و کارهای بعدی از آنها استفاده کند. به این ترتیب، کاربر مجبور نیست برای هر درخواست، تمام اطلاعات و ترجیحات خود را از ابتدا توضیح دهد.
متا برای بررسی این توانایی به آزمون MemoryBench اشاره کرده است. این آزمون میزان توانایی مدلها در یادگیری مداوم، نگهداری اطلاعات و ساختن حافظهای منظم از دادههای دریافتی را ارزیابی میکند. طبق نتایج اعلام شده از سوی متا، مدل Muse Wonder در این آزمون امتیاز بالاتری از مدلهای Fable، Opus و Astra کسب کرده است.
کاویا کوپاراپو (Kavya Kopparapu)، پژوهشگر متا، در ویدیویی که همزمان با معرفی مدلها منتشر شد، گفت این شرکت تلاش زیادی کرده است تا مدل هوش مصنوعی بتواند اطلاعات مهم مربوط به هر کاربر را در بازههای زمانی طولانی، از چند روز و چند هفته تا چند ماه و حتی بیشتر، به خاطر بسپارد.
عرضه این دو مدل همچنین نخستین انتشار یک مدل پیشرفته از سوی متا پس از تغییرات اساسی در ساختار فعالیتهای هوش مصنوعی این شرکت است. این تغییرات در اوت سال گذشته و پس از بازسازماندهی بخش هوش مصنوعی متا به رهبری الکساندر وانگ، بنیانگذار شرکت Scale AI، انجام شد. از آن زمان، متا مدل سبکتر Muse Spark و دستیار Muse را معرفی کرده بود، اما کمتر به عرضه مدلهایی در سطح پیشرفتهترین محصولات شرکتهایی مانند OpenAI و Anthropic پرداخته بود.
بر اساس توضیحات منتشر شده، مدلهای جدید در مرکز داده پرومتئوس متا در مرکز ایالت اوهایو آموزش داده شدهاند؛ مرکزی که فعالیت خود را در اوایل سال جاری میلادی آغاز کرده است. معرفی این مدلها نشان میدهد متا در تلاش است علاوه بر افزایش قدرت پردازش و توانایی انجام وظایف پیچیده، حافظه و قدرت شناخت بلندمدت دستیارهای هوش مصنوعی خود را نیز بهبود دهد.
اولین نفری باشید که دیدگاه میگذارد