
شرکت OpenAI اعلام کرده است که برای رعایت قانون هوش مصنوعی اتحادیه اروپا، از این پس روی متنهایی که ChatGPT و Codex تولید میکنند، یک واترمارک نامرئی قرار میدهد. این شرکت روز دوشنبه در یک پست وبلاگی اعلام کرد که این اقدام فعلاً تنها در اتحادیه اروپا انجام خواهد شد.
بر اساس قوانین شفافیت قانون هوش مصنوعی اتحادیه اروپا که از 2 اوت (11 مرداد) اجرایی شده، شرکتهای فعال در حوزه هوش مصنوعی باید محتوای تولید شده توسط هوش مصنوعی را به شکلی مشخص کنند که سیستمهای دیگر بتوانند آن را شناسایی کنند.
OpenAI اعلام کرده است که این واترمارک طی چند هفته آینده برای کاربران واجد شرایط ChatGPT و Codex در همه طرحها فعال میشود، اما فعلاً فقط در اتحادیه اروپا در دسترس خواهد بود.
توسعهدهندگانی که در هر نقطه از جهان از API شرکت OpenAI استفاده میکنند، میتوانند از امروز این قابلیت را برای برخی مدلها فعال کنند. این قابلیت به صورت پیشفرض خاموش است. OpenAI همچنین گفته است که در زمان عرضه، قصد ندارد واترمارک متن را به طور پیشفرض در سراسر جهان فعال کند.
این واترمارک یک علامت یا نشانه قابل مشاهده نیست. در عوض، مدل هوش مصنوعی به شکل بسیار ظریفی انتخاب کلمات را تغییر میدهد و الگویی در متن ایجاد میکند که خواننده نمیتواند آن را ببیند، اما ابزارهای تشخیصی میتوانند آن را شناسایی کنند. از آنجا که این الگو در خود کلمات متن قرار دارد، هنگام کپی و چسباندن متن نیز همراه آن منتقل میشود.
OpenAI گفته است که این واترمارک اطلاعاتی درباره هویت کاربر نشان نمیدهد. این شرکت همچنین اعلام کرده که فعال کردن واترمارک تغییر قابل توجهی در عملکرد مدلهایش ایجاد نکرده است. این شرکت همزمان با اعلام این خبر، یک گزارش فنی درباره روش خود با نام textGrain منتشر کرده است. این گزارش با همکاری پژوهشگرانی از دانشگاه پنسیلوانیا و دانشگاه ییل نوشته شده و توضیح میدهد که این روش چگونه کار میکند.
برای مثال، مدل با استفاده از یک کلید مخفی، کلمات احتمالی برای ادامه جمله را مرتب میکند و به شکل خاصی از میان آنها انتخاب میکند. اگر این تغییرات کوچک در صدها بخش از متن تکرار شوند، ابزار تشخیصی میتواند فقط با بررسی متن و استفاده از آن کلید، تشخیص دهد که متن توسط هوش مصنوعی تولید شده است.
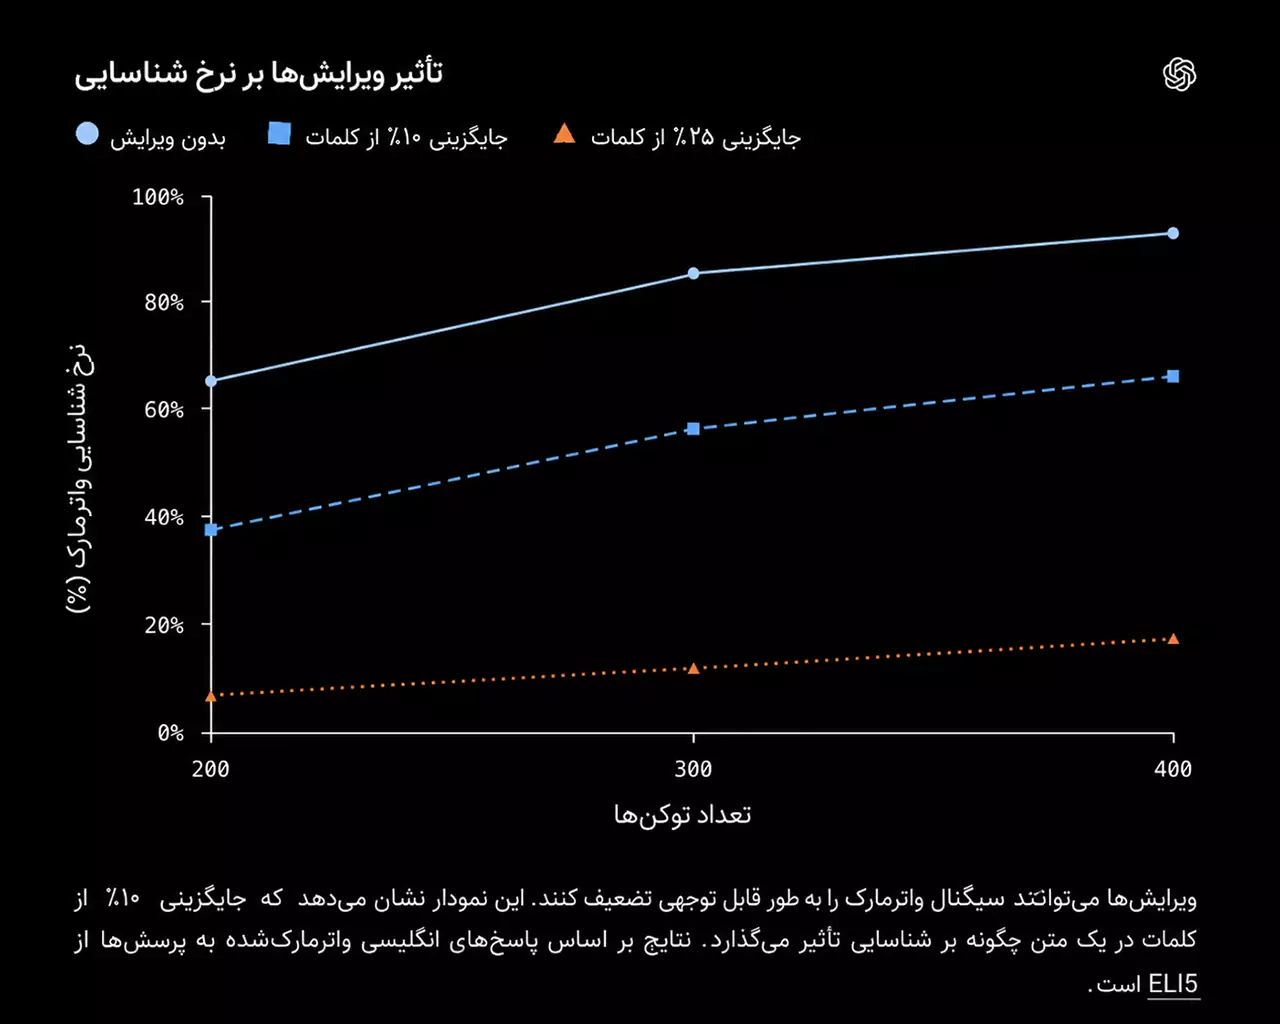
اما آیا میتوان با ویرایش متن، این واترمارک را از بین برد؟ آزمایشهای OpenAI نشان میدهد که این کار امکانپذیر است. در یکی از آزمایشها، جایگزین کردن 10 درصد از کلمات با مترادفهای آنها باعث شد دقت تشخیص از حدود 92 درصد به 66 درصد کاهش پیدا کند. OpenAI همچنین گفته است که تشخیص واترمارک در متنهای کوتاه، پاسخهای ریاضی و متنهای ترجمه شده دشوارتر است.
این شرکت گفته است:
این محدودیتها باعث شده تصمیم بگیریم در مرحله اول، دسترسی به ابزار تشخیص واترمارک را فقط در اختیار پژوهشگران تأیید شده و سازمانهای متخصص قرار دهیم. آنها میتوانند به ما در بررسی میزان دقت این ابزار و استفاده درست و مسئولانه از آن کمک کنند.
OpenAI همچنین هشدار داده است که نبودن واترمارک به این معنی نیست که متن حتماً توسط یک انسان نوشته شده است. ممکن است متن بیش از حد کوتاه باشد، تغییرات زیادی روی آن انجام شده باشد یا با استفاده از ابزار هوش مصنوعی یک شرکت دیگر تولید شده باشد.
OpenAI گفته است:
واترمارک میتواند نشان دهد که بخشی از یک متن توسط یکی از سیستمهای OpenAI تولید یا پردازش شده است، اما مشخص نمیکند چه میزان از ویرایش یا خلاقیت انسان در تولید آن متن نقش داشته است.
این خبر دو ماه پس از آن منتشر شده که شرکت آنتروپیک اعلام کرد متنهای تولید شده توسط مدل Claude را در سراسر جهان واترمارک میکند. این تصمیم با واکنش منفی برخی کاربران Claude روبهرو شد. آنها معتقد بودند که خودشان «دستورها، اطلاعات و تصمیمها» را در اختیار هوش مصنوعی قرار دادهاند و Claude فقط «یک ابزار» بوده است، بنابراین حق ندارد متن را به نام خود ثبت کند.
بر اساس گزارشی که والاستریت ژورنال در سال 2024 منتشر کرد، OpenAI پیش از این یک سیستم واترمارک برای متن ساخته بود، اما از انتشار آن خودداری کرد. یکی از دلایل این تصمیم، نگرانی از این بود که کاربران به سراغ رقبایی بروند که از واترمارک استفاده نمیکردند.
در حال حاضر، شرکتهای آنتروپیک، گوگل، متا، مایکروسافت و OpenAI از جمله شرکتهایی هستند که متعهد شدهاند از قوانین و دستورالعملهای اتحادیه اروپا درباره محتوای تولید شده با هوش مصنوعی پیروی کنند.

اولین نفری باشید که دیدگاه میگذارد